Repos GitHub pertinents - Intelligences artificielles et API
Thématiques

Mise à jour dans la base Othman Ben Brahim - Veille d'outils tech par Othman Ben Brahim
Publiée le 19.03.2026 ︱ Mise à jour le 16.09.2026

Repos GitHub pertinents - Intelligences artificielles et API
Cette ressource a pour but de dénicher les pépites de la tech, à travers des repos GitHub, concernant les IA open source et les API publics et gratuites recueilli au fil de l'eau, qui peuvent être très utiles dans le domaine de la programmation. Donc, à direction d'un public averti.
246 VuesVues·3 Enregistrements
PageIndex : RAG sans vecteurs, basé sur le raisonnement
Inspiré par AlphaGo, nous proposons PageIndex — un système RAG sans vecteurs, basé sur le raisonnement, qui construit un index arborescent hiérarchique à partir de documents longs et utilise des LLM pour raisonner sur cet index afin d'effectuer une récupération agentique et contextuelle. Il simule la manière dont les experts humains naviguent et extraient des connaissances de documents complexes via une recherche arborescente, permettant aux LLM de penser et de raisonner pour trouver les sections de documents les plus pertinentes. PageIndex effectue la récupération en deux étapes :
1- Générer un index en structure arborescente de type « Table des matières » des documents
2- Effectuer une récupération basée sur le raisonnement via la recherche arborescente
PageIndex
📑 PageIndex: Document Index for Vectorless, Reasoning-based RAG - VectifyAI/PageIndex

https://github.com/VectifyAI/PageIndex

1 clic sur ce lien
Hindsight
Hindsight™ est un système de mémoire d'agent conçu pour créer des agents plus intelligents qui apprennent au fil du temps. La plupart des systèmes de mémoire d'agent se concentrent sur le rappel de l'historique des conversations. Hindsight se concentre sur la création d'agents qui apprennent, pas seulement sur la mémoire. Elle élimine les lacunes des techniques alternatives telles que RAG et les graphes de connaissances et offre des performances de pointe pour les tâches de mémoire à long terme.
Hindsight
GitHub - vectorize-io/hindsight: Hindsight: Agent Memory That Learns Ouverture dans un nouvel onglet
Hindsight: Agent Memory That Learns. Contribute to vectorize-io/hindsight development by creating an account on GitHub.
https://github.com/vectorize-io/hindsight?tab=readme-ov-file

0 clics sur ce lien
code-review-graph
Vous pouvez maintenant donner à Claude Code une carte visuelle de toute votre base de code.
Un outil open-source qui construit un graphique local de tout votre projet pour que Claude sache instantanément comment chaque fichier est connecté ensemble.
- Fonctionne 100% localement sur votre machine.
- Cartographie automatiquement toute la structure de votre dépôt.
- Donne à Claude Code le contexte exact dont il a besoin pour construire sans halluciner.
Lien ressource: GitHub
Local knowledge graph for Claude Code. Builds a persistent map of your codebase so Claude reads only what matters — 6.8× fewer tokens on reviews and up to 49× on daily coding tasks. - tirth8205/code-review-graph
https://github.com/tirth8205/code-review-graph

1 clic sur ce lien
Public APIs
Le répertoire des API publiques est géré manuellement par des membres de la communauté comme vous et l'équipe d'APILayer. Il contient une liste exhaustive d'API publiques issues de nombreux domaines que vous pouvez utiliser pour vos propres produits. Considérez-le comme une véritable mine d'API, précieusement conservées par la communauté depuis des années.
Public APIs
GitHub - public-apis/public-apis: A collective list of free APIs Ouverture dans un nouvel onglet
A collective list of free APIs. Contribute to public-apis/public-apis development by creating an account on GitHub.
https://github.com/public-apis/public-apis

0 clics sur ce lien
Screenpipe
screenpipe transforme votre ordinateur en une intelligence artificielle personnelle qui connaît tout ce que vous avez fait. Enregistrez. Recherchez. Automatisez. Tout est local, privé et à vous.
Repos Screenpipe
run agents that work for you in the background based on what you do - screenpipe/screenpipe
https://github.com/screenpipe/screenpipe

0 clics sur ce lien
IWE - graphe de connaissance hiérarchisé pour IA
IWE est un graphe de connaissances qui organise vos notes de manière hiérarchique et les rend accessibles aux agents IA. Écrivez en Markdown, structurez avec des liens, donnez aux agents IA les outils pour naviguer dans votre savoir.
IWE ne possède pas d'IA intégrée — il est conçu pour fonctionner avec des outils IA externes (comme Claude, Codex, Gemini, et d'autres). L'interface en ligne de commande (CLI) offre un accès structuré à votre graphe de connaissances, que vous écriviez vos propres scripts ou que vous fournissiez aux agents IA les outils et le contexte dont ils ont besoin.
Lien ressource: GitHub
Markdown memory system for you and your AI agent. Contribute to iwe-org/iwe development by creating an account on GitHub.
https://github.com/iwe-org/iwe

0 clics sur ce lien
memU: votre mémoire personnel, stocké comme un wiki

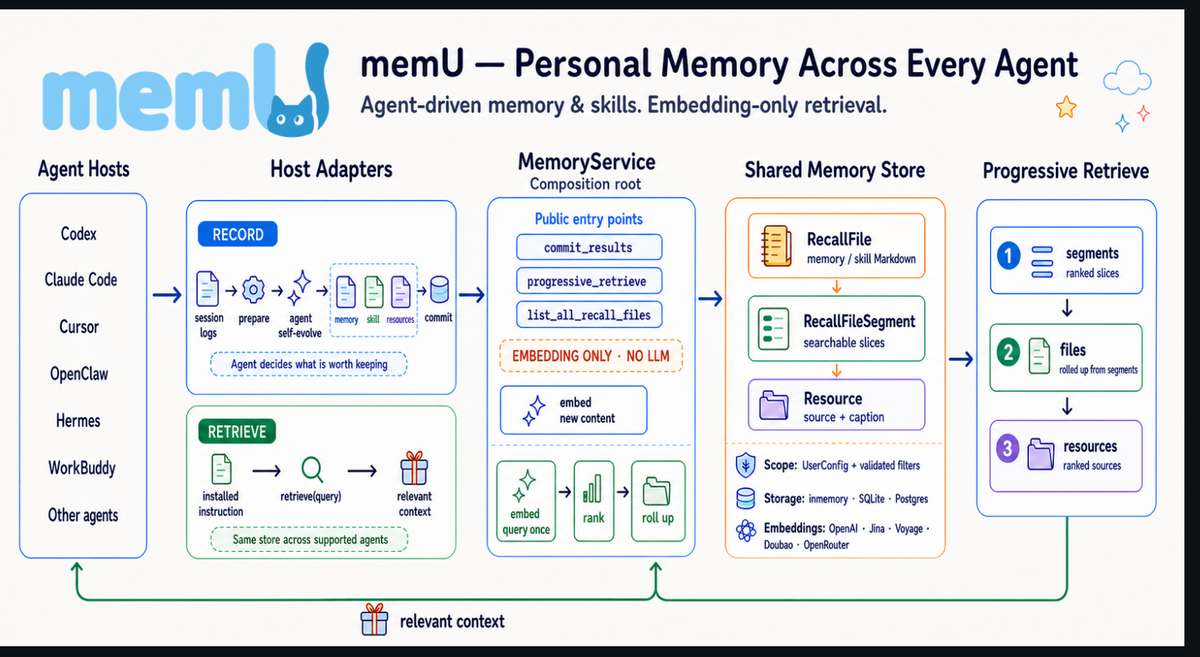
Ce dépôt GitHub (NevaMind-AI/memU) est un système de mémoire personnel et léger conçu pour les agents IA de développement (comme Cursor, Claude Code, etc.).
Son but est de résoudre un problème courant avec l'IA : chaque nouvelle session repart souvent de zéro. memU agit comme un "Wiki" partagé qui permet à l'IA d'apprendre de vos préférences et de vos méthodes de résolution de problèmes, et de les conserver à travers différentes sessions, différents agents et différents appareils.
Voici les concepts clés et le fonctionnement technique de ce dépôt :
Le principe de base
Au lieu de conserver un historique chaotique de tout ce que vous avez dit, memU extrait automatiquement des "compétences" (skills) de vos sessions de travail. Son code central est très minimaliste (environ 500 lignes), ce qui le rend facile à inspecter.
Tout ce qui est mémorisé est enregistré sous forme de fichiers Markdown lisibles par l'humain, ce qui vous permet de lire, modifier ou supprimer ce que l'IA a appris sur vous.
Comment memU mémorise-t-il l'information ?
Le cycle de vie de la mémoire avec memU se déroule en 5 étapes automatisées :
1.Capture des sessions :Lecture des logs.
Un processus en arrière-plan (adaptateur) surveille et lit l'historique de vos sessions récentes avec l'agent, y compris les messages et les appels d'outils.
2.Préparation de l'auto-évolution :
memU découpe les informations pertinentes de la session pour les présenter sous forme de "tâche" condensée à analyser.
3.Prise de décision par l'Agent :
L'agent IA relit cet historique de session, consulte ses compétences existantes, et choisit s'il doit créer une nouvelle compétence, en mettre une à jour (patch), ou ne rien faire.
4.Écriture et Indexation :Format Markdown + Vectorisation.
L'agent rédige la compétence dans un format précis (nom, description, flux de travail, pièges à éviter). memU convertit ensuite ce résumé en vecteurs mathématiques (Embeddings) et l'indexe dans une base de données.
5.Récupération automatique (Retrieval) :
Lors de vos sessions futures, une instruction force l'agent à interroger memU avant de vous répondre. Grâce à la recherche vectorielle, memU lui fournit le bon fichier Markdown correspondant à la tâche en cours.
L'architecture technique (Les adaptateurs)
memU s'installe sous forme de "Sidecar" (un processus parallèle) et utilise des "adaptateurs" dédiés pour chaque outil. Par exemple, si vous utilisez Cursor, il utilisera memu-cursor, si vous utilisez Claude Code, ce sera memu-claude-code.
Chaque adaptateur accomplit deux tâches :
Record : Il lit les logs natifs de l'outil (ex: ~/.cursor/projects/.../agent-transcripts/).
Inject : Il modifie les fichiers d'instructions système de l'agent (comme AGENTS.md ou CLAUDE.md) pour lui apprendre comment interroger l'exécutable memU avant de générer une réponse.
Stockage et Compatibilité
Stockage : Le système est flexible. Vous pouvez l'utiliser en version Cloud (synchronisé via memu.so) pour partager la mémoire entre vos appareils, ou en Auto-hébergé (Local) où toutes vos données restent sur votre machine via une base de données SQLite ou PostgreSQL locale.
Compatibilité : Le dépôt indique qu'il supporte actuellement Claude Code, Cursor, OpenClaw, Hermes, WorkBuddy et Codex sur les systèmes macOS, Windows et Linux.
Lien ressource: GitHub
GitHub - NevaMind-AI/memU: Personal memory across agents Ouverture dans un nouvel onglet
Personal memory across agents. Contribute to NevaMind-AI/memU development by creating an account on GitHub.
https://github.com/NevaMind-AI/memU

0 clics sur ce lien
A venir : d'autres applications viendront plus tard (veille techno)
alphaXiv/OpenResearch
Voici ce que ce projet permet de faire concrètement :
Recherche autonome (Autoresearch) : L'outil permet à l'IA de gérer une boucle d'expérimentation complète de façon autonome. L'agent peut proposer une idée, modifier le code, lancer une expérience, analyser les résultats et décider de la prochaine étape à tester.
Revue de littérature et production d'artefacts : Les agents peuvent analyser des publications scientifiques (via arXiv ou DOI), développer des hypothèses et générer des documents de recherche.
Exploration en parallèle : Vous pouvez lancer plusieurs agents simultanément sur différentes directions de recherche. Chacun obtient sa propre session indépendante et un espace de travail isolé (via les worktrees de Git).
Expériences reproductibles et traçables : OpenResearch crée un "arbre d'expérimentation" basé sur Git. Chaque test exécuté sauvegarde de manière immuable le code exact, les logs, les différences (diffs) et les résultats associés.
Flexibilité d'exécution (Compute) : Vous pouvez faire tourner ces expériences directement sur votre machine locale, ou bien sur des infrastructures distantes et des clusters de calcul (via SSH, Slurm, Kubernetes, Ray, Modal, etc.).
Confidentialité (Local par défaut) : Tout est conservé sur votre machine grâce à une base de données locale SQLite. Vos projets, conversations, logs, et codes ne sont pas envoyés sur le cloud sans votre permission.
alphaXiv/OpenResearch
Turn your coding agents into research agents. Contribute to alphaXiv/OpenResearch development by creating an account on GitHub.
https://github.com/alphaXiv/OpenResearch

0 clics sur ce lien
Thématiques
Type de ressource
Bénéficiaires
Secteurs professionnels
Pas de licence· Domaine public, libre de restrictions de droits d’auteur